人物边说边摘下眼镜,镜头缓慢推近。配音:ALLE。
素材
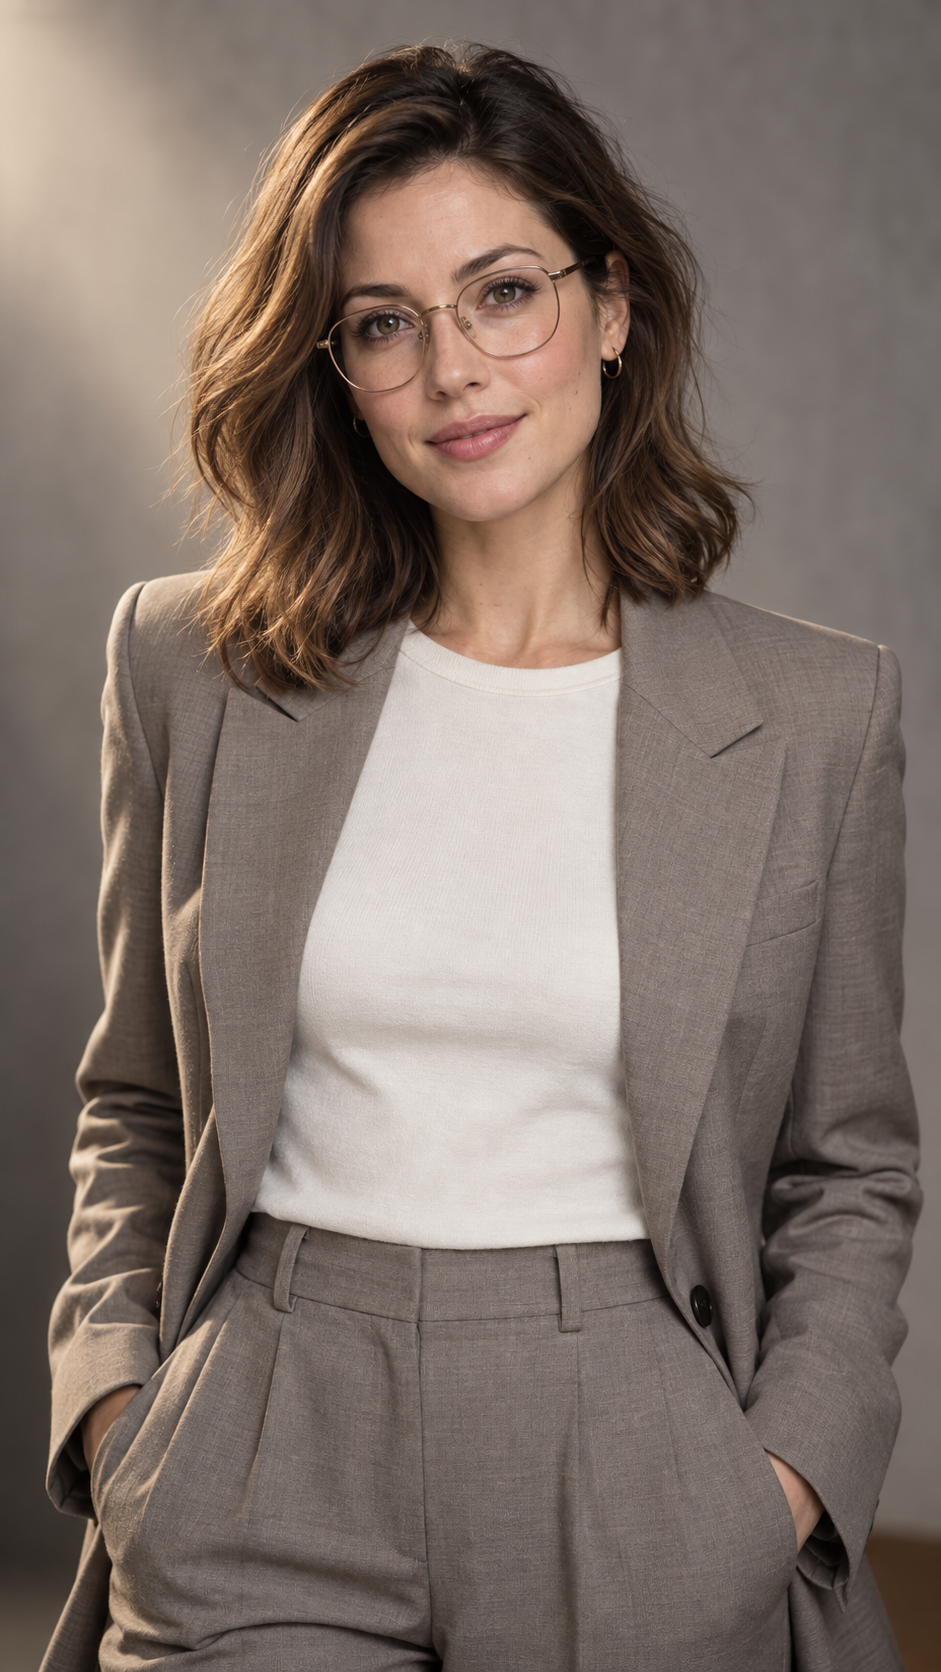
动作: 她慢慢摘下眼镜,露出面容。 镜头: 镜头缓慢而轻柔地推近她的脸部,最后停在面部特写。 配音: ALLE (英语 · 女性 · 青年 · 活力)
ALLE 声音试听(非案例台词)
生成结果
边说边摘下眼镜
上传一张照片,用音频或文字驱动口型。描述人物动作与镜头运动,让人物边说边动,最长 30 秒。

最近生成
人物边说边摘下眼镜,镜头缓慢推近。配音:ALLE。
素材
动作: 她慢慢摘下眼镜,露出面容。 镜头: 镜头缓慢而轻柔地推近她的脸部,最后停在面部特写。 配音: ALLE (英语 · 女性 · 青年 · 活力)
ALLE 声音试听(非案例台词)
生成结果
边说边摘下眼镜
动作控制对口型把照片、语音和文字动作描述组合成视频。你可以分别描述人物动作与镜头运动,并用上传的音频或文字配音驱动口型。本工具使用 Super,单次最长 30 秒;动作来自文字描述,无需参考动作视频。
输入动作描述,让人物说话时自然运动。
描述推近、拉远或构图变化。
使用录音或 AI 配音,最长 30 秒 / 150 个有效字符。
选择单人、面部与嘴部清晰可见的照片。
上传音频或输入配音文本,分别填写动作与镜头描述。
检查口型、动作与人物一致性,再下载视频。
让人物在说话时摘眼镜、转头或做轻微手势。
用手势和缓慢推镜头强化讲解内容。
所有 FreeLipSync 工具使用同一引擎,按你的素材类型选择合适的工作流。
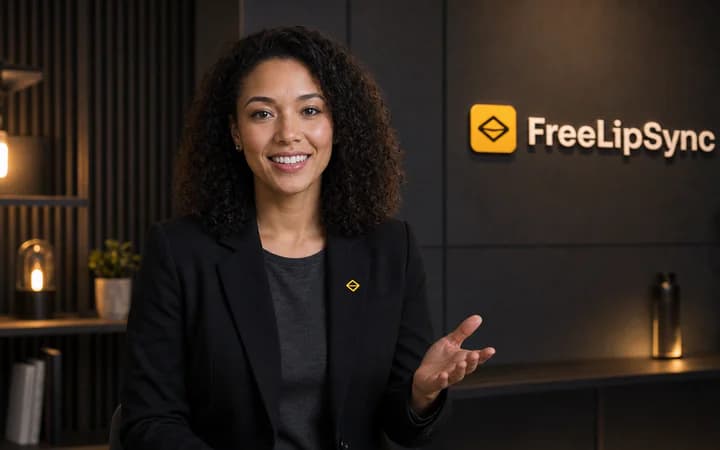
上传一张人脸照片,输入文案,就能用聚焦的口型同步流程生成会说话的视频。
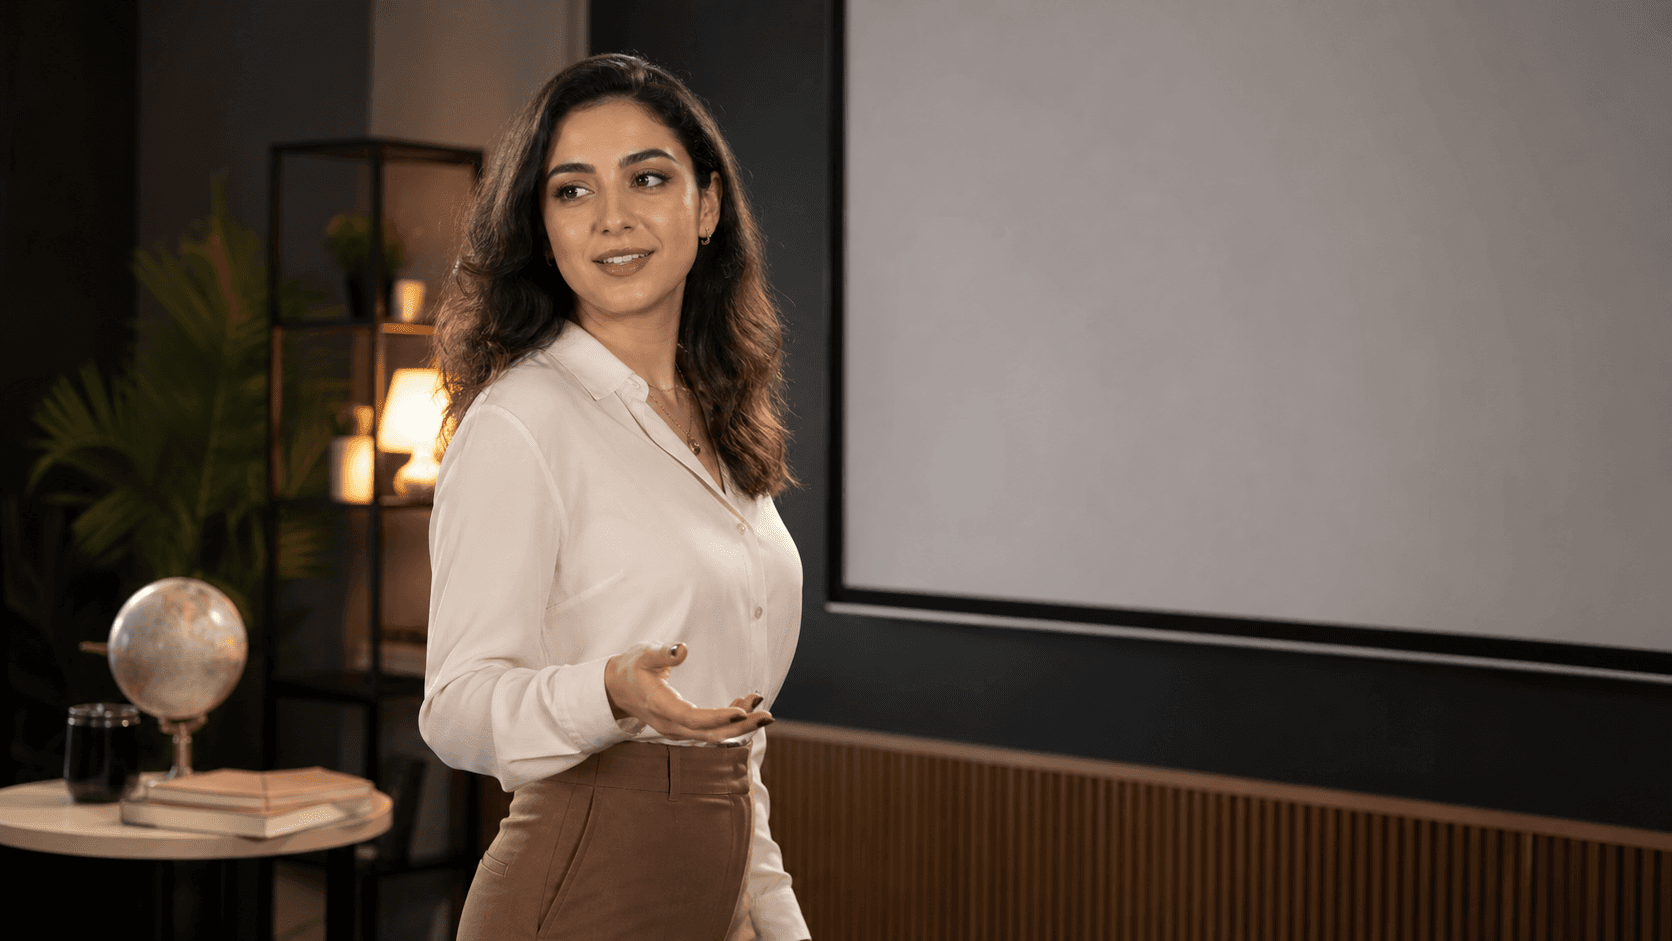
上传一张人脸照片,再添加音频,就能把静态图片转换成跟随声音说话的视频。
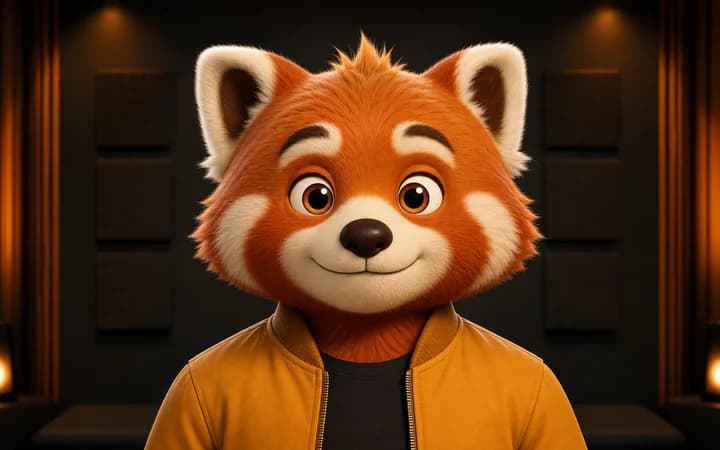
上传卡通或动漫角色图片,再用文字或配音音频生成口型精准的角色说话动画。
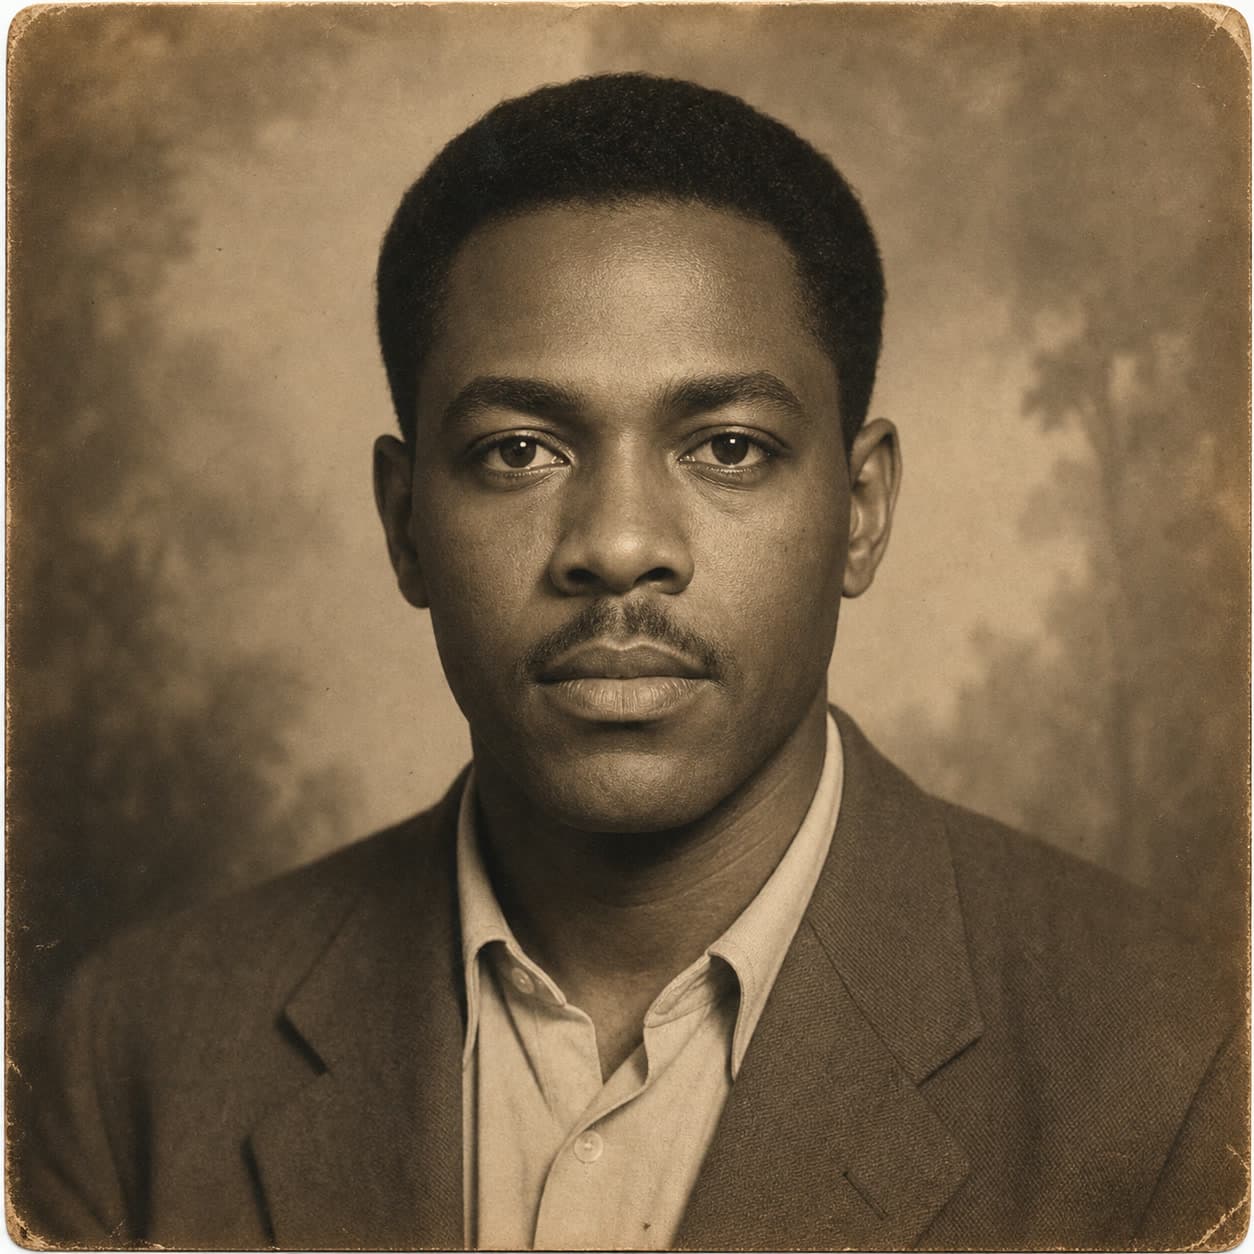
让家里的老照片重新鲜活——输入一段话或添加录音,肖像就会温柔自然地说出来。