
为播客或音乐视频编排双人全景、单人特写、分段音频和可选运镜,制作有明确镜头顺序的多片段 AI 对口型视频。
哪些场景适合这样做?
一张说话照片适合连续镜头;当对话需要切到提问者和回答者,或歌曲需要交替突出男女歌手时,就要先设计镜头顺序。多镜头工具负责按你提供的图片和每段音频生成、拼接场景,而不是凭空替你画好所有分镜。先决定每段由谁说或唱,再准备对应画面,比生成后才修正人物关系更省事。
制作步骤
-
列出分镜 把台词或歌词分配给双人全景与各自的特写,明确每段的主角。
-
配对图和声音 为每个场景放入匹配的图片和音频或文本,不要把另一人的声轨误放进特写。
-
安排顺序和动作 排好场景,必要时为镜头补充动作或运镜指令。
-
检查完整作品 从头看到尾,核对人物、说话次序、场景连接和音频连续性。
已完成的案例
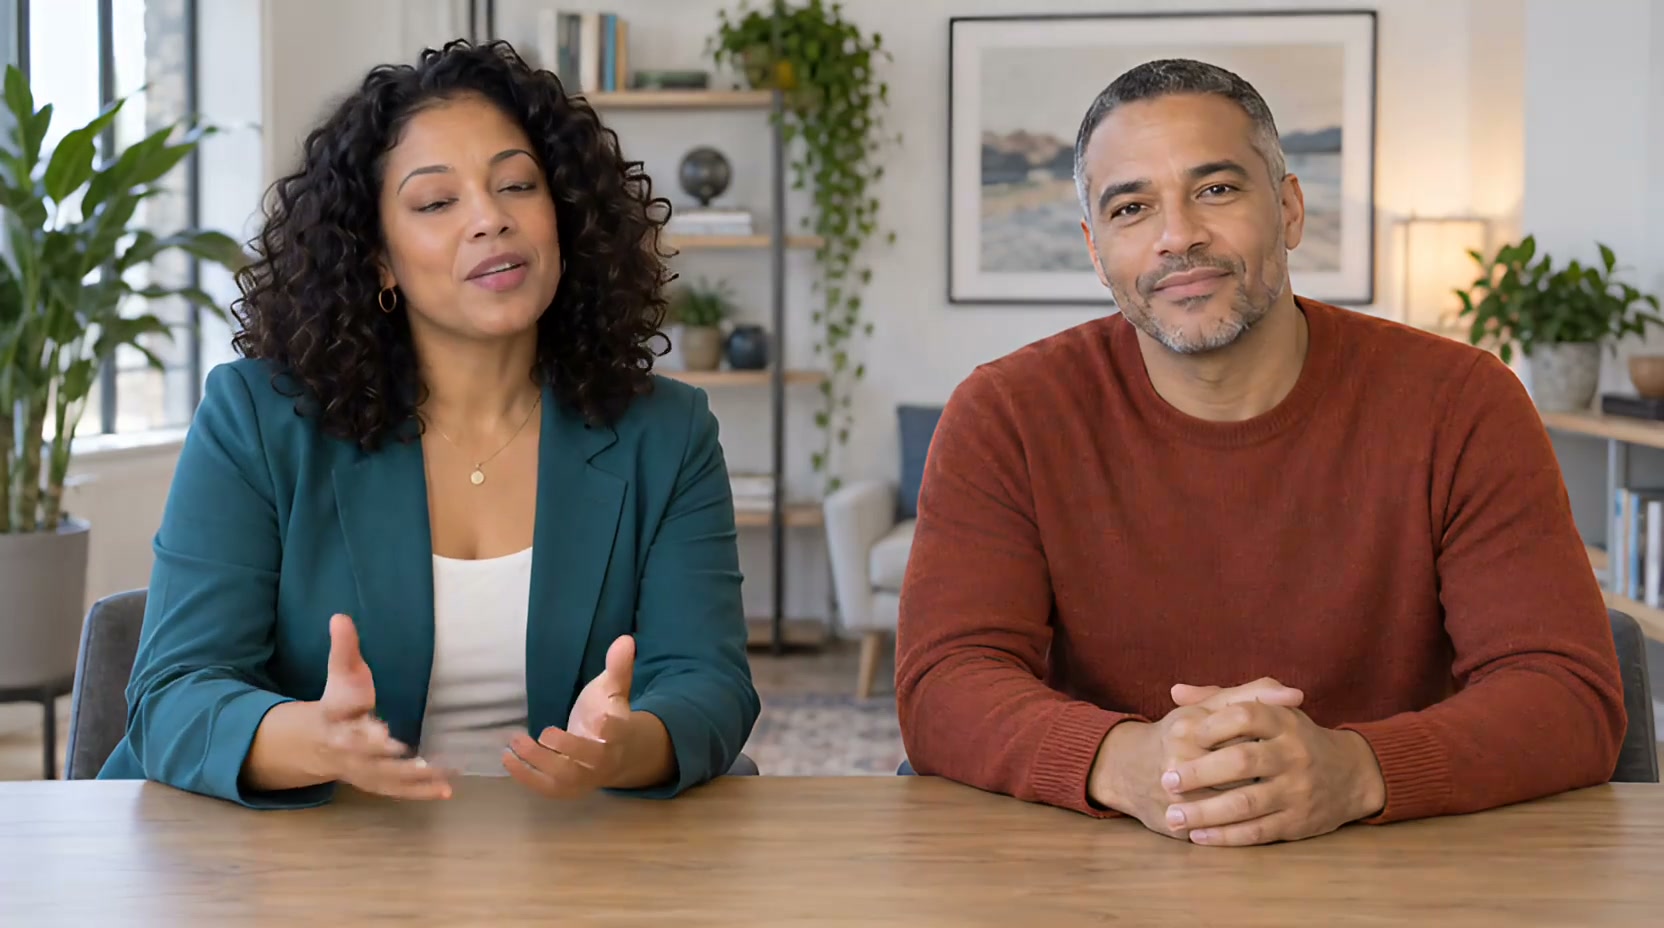
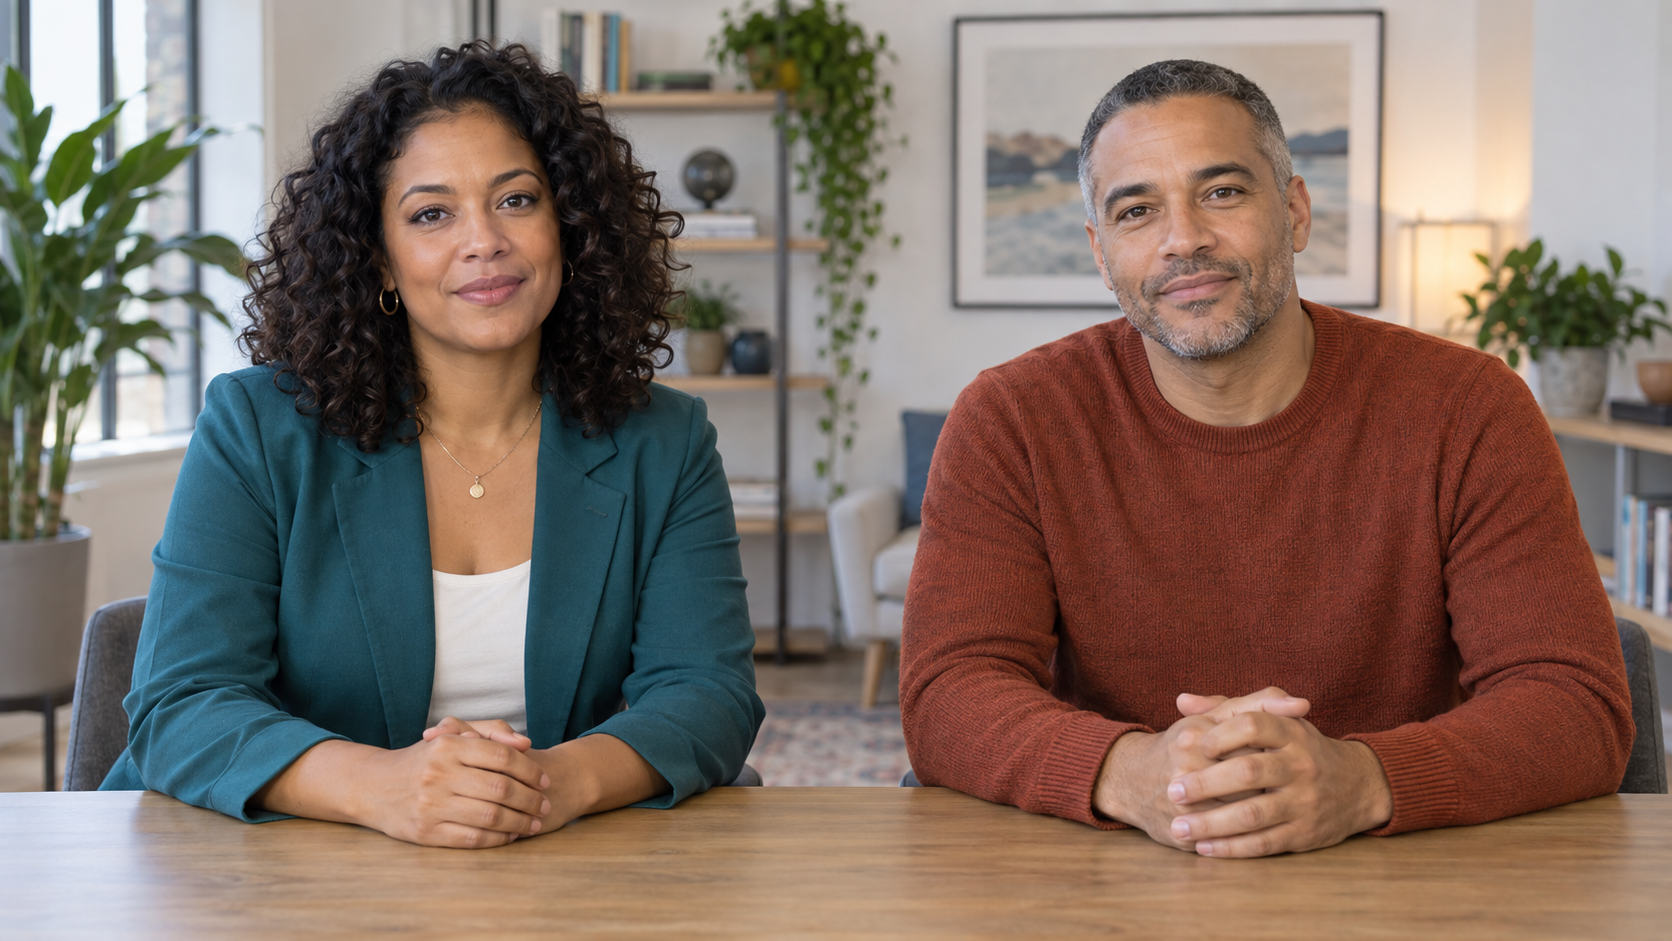
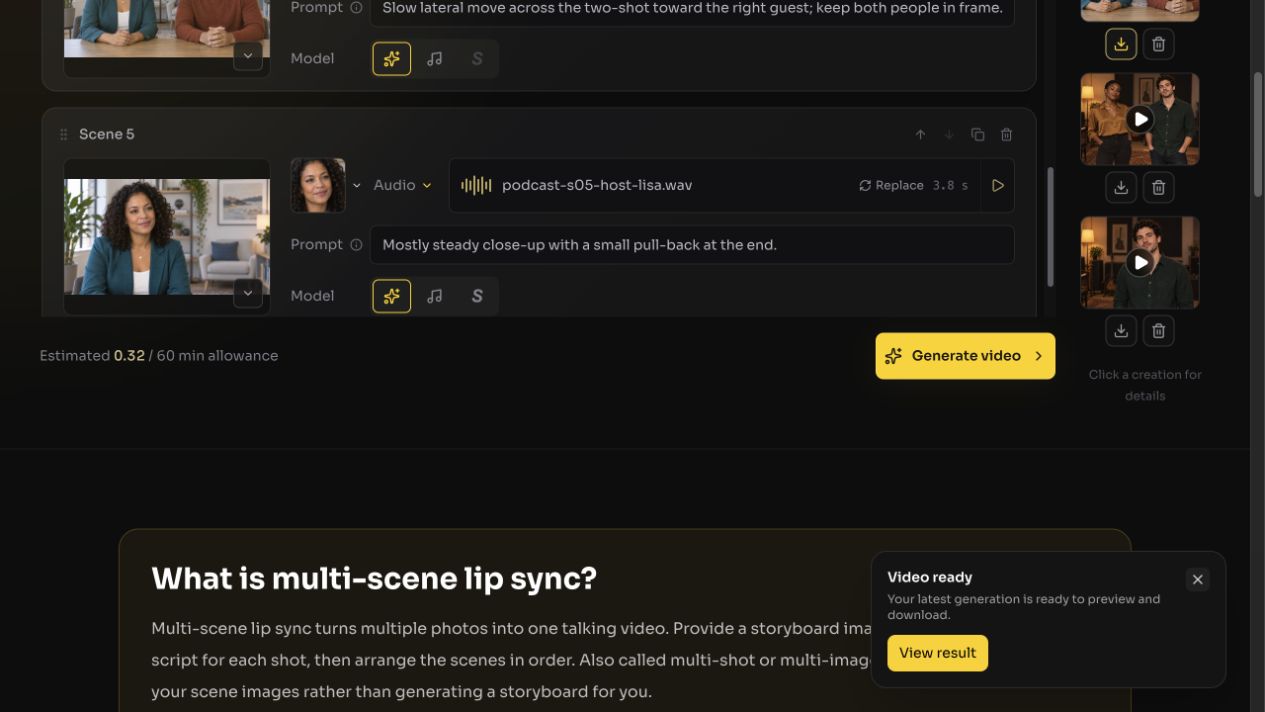
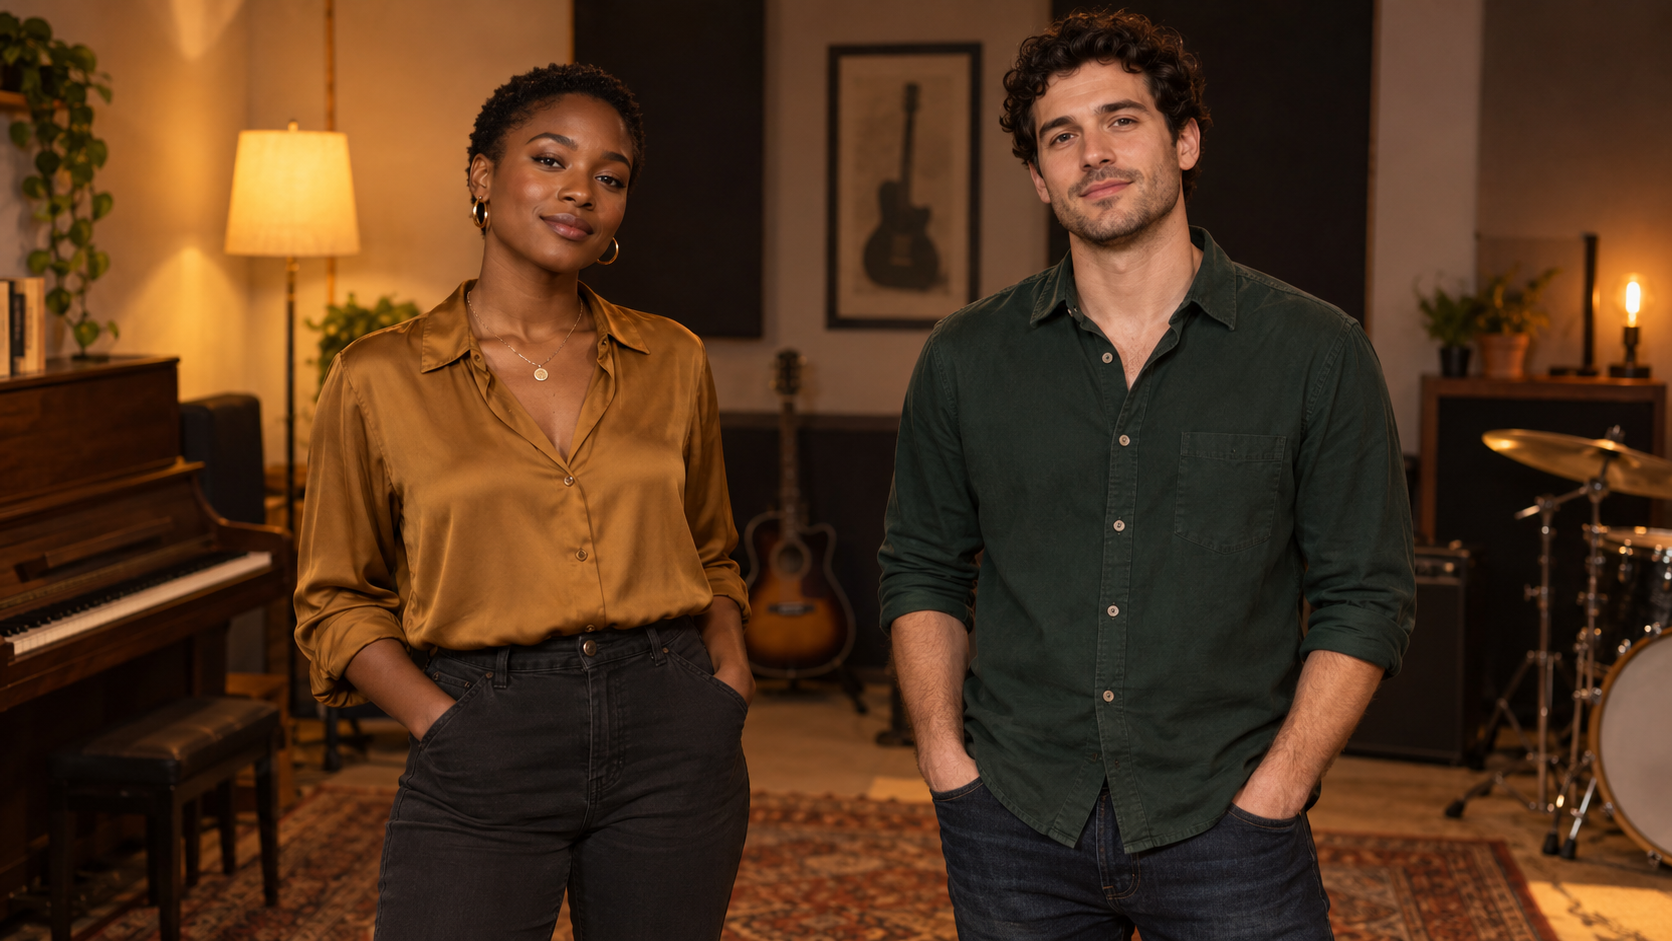
页面提供两套已生成的五镜头示例:主持人与嘉宾播客,以及双人音乐视频。截图展示场景在编辑器中的排列;图片展示双人全景和特写如何对应声音,不需要另拍素材。
发布前检查什么?
多段视频的难点是跨镜头的人物一致性和转场节奏。双人同框段落可使用适合双人演唱的模式,单人特写则按该镜头的目标效果选择模式;不要假设一句提示词能精确控制每个切点。
常见问题
工具会自动设计所有镜头吗?
不会。先为每段准备对应图片和声音,再在时间线上排列镜头;需要时添加动作或运镜。


