
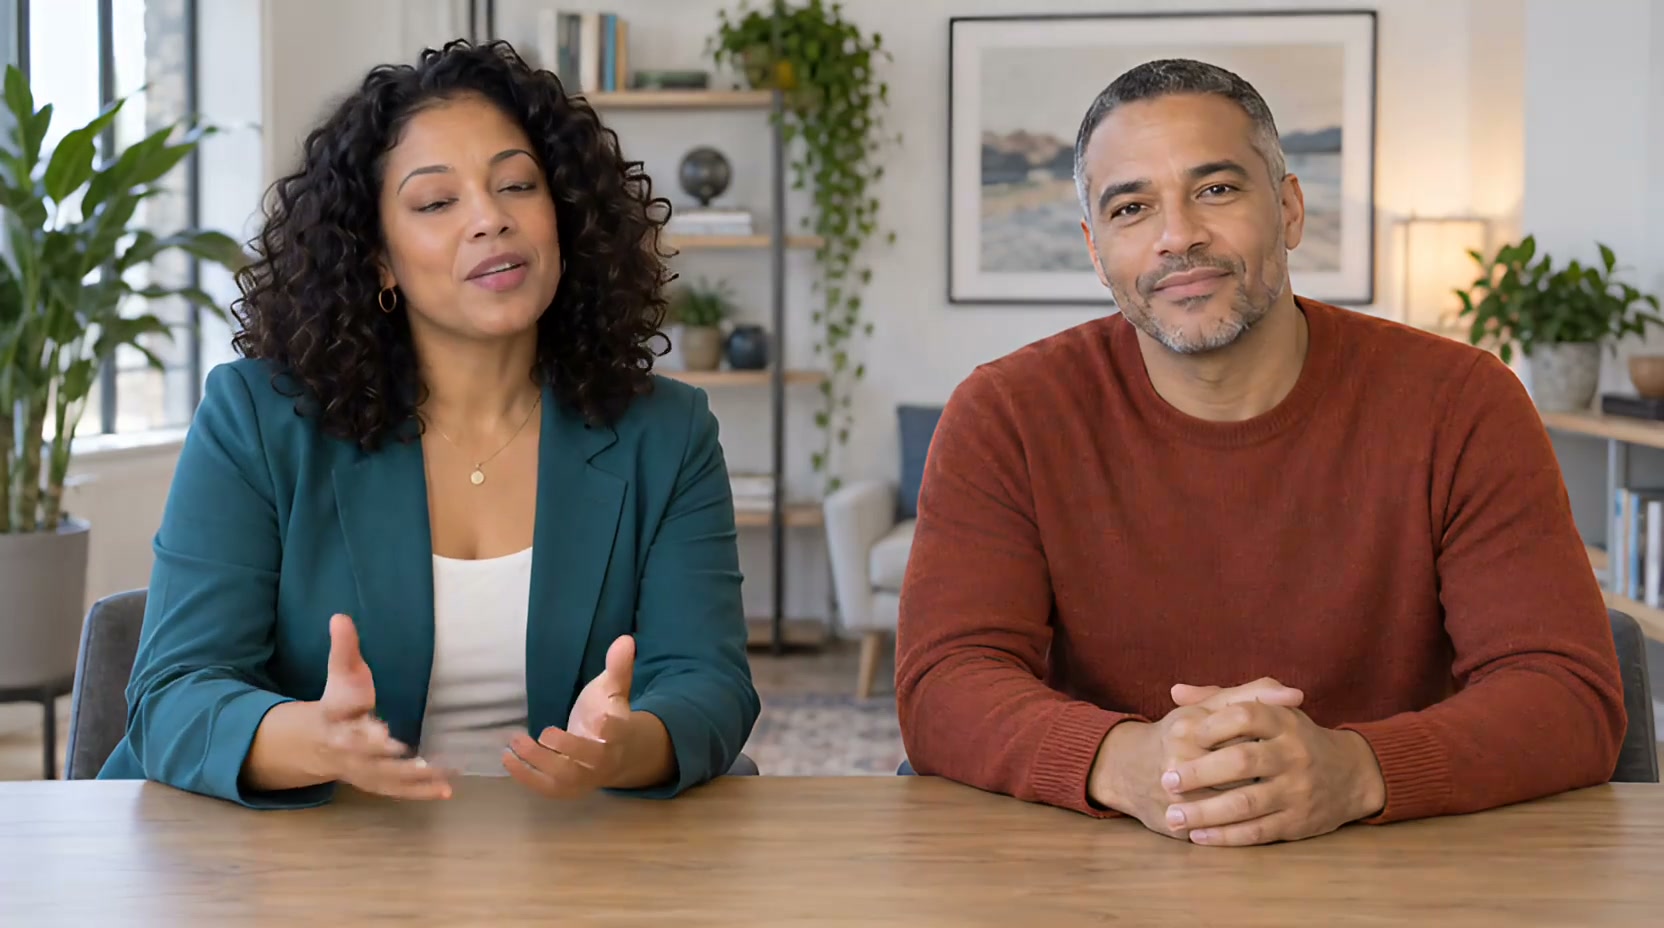
رتب لقطات الشخصين واللقطات المقربة والصوت لكل مشهد وحركة الكاميرا الاختيارية لفيديو بودكاست أو موسيقي.
متى يفيد هذا الأسلوب؟
تصلح صورة واحدة للقطة متصلة. أما إذا أردت التنقل بين مقدم البرنامج والضيف، أو إبراز مغنيين بالتناوب، فخطط لترتيب اللقطات أولًا. تستخدم الأداة الصور والصوت اللذين تقدمهما، ولا ترسم تلقائيًا كل صور مخطط المشاهد.
خطوات التنفيذ
-
وزع اللقطات خصص لكل جملة أو مقطع غنائي لقطة ثنائية أو مقربة.
-
طابق الصورة بالصوت ضع صورة المتحدث أو المغني وصوته في المشهد الصحيح.
-
رتب المشاهد أضف تعليمات حركة اختيارية عند الحاجة.
-
راجع العمل كاملًا تحقق من الشخصيات والانتقالات واستمرارية الصوت.
مثال جاهز
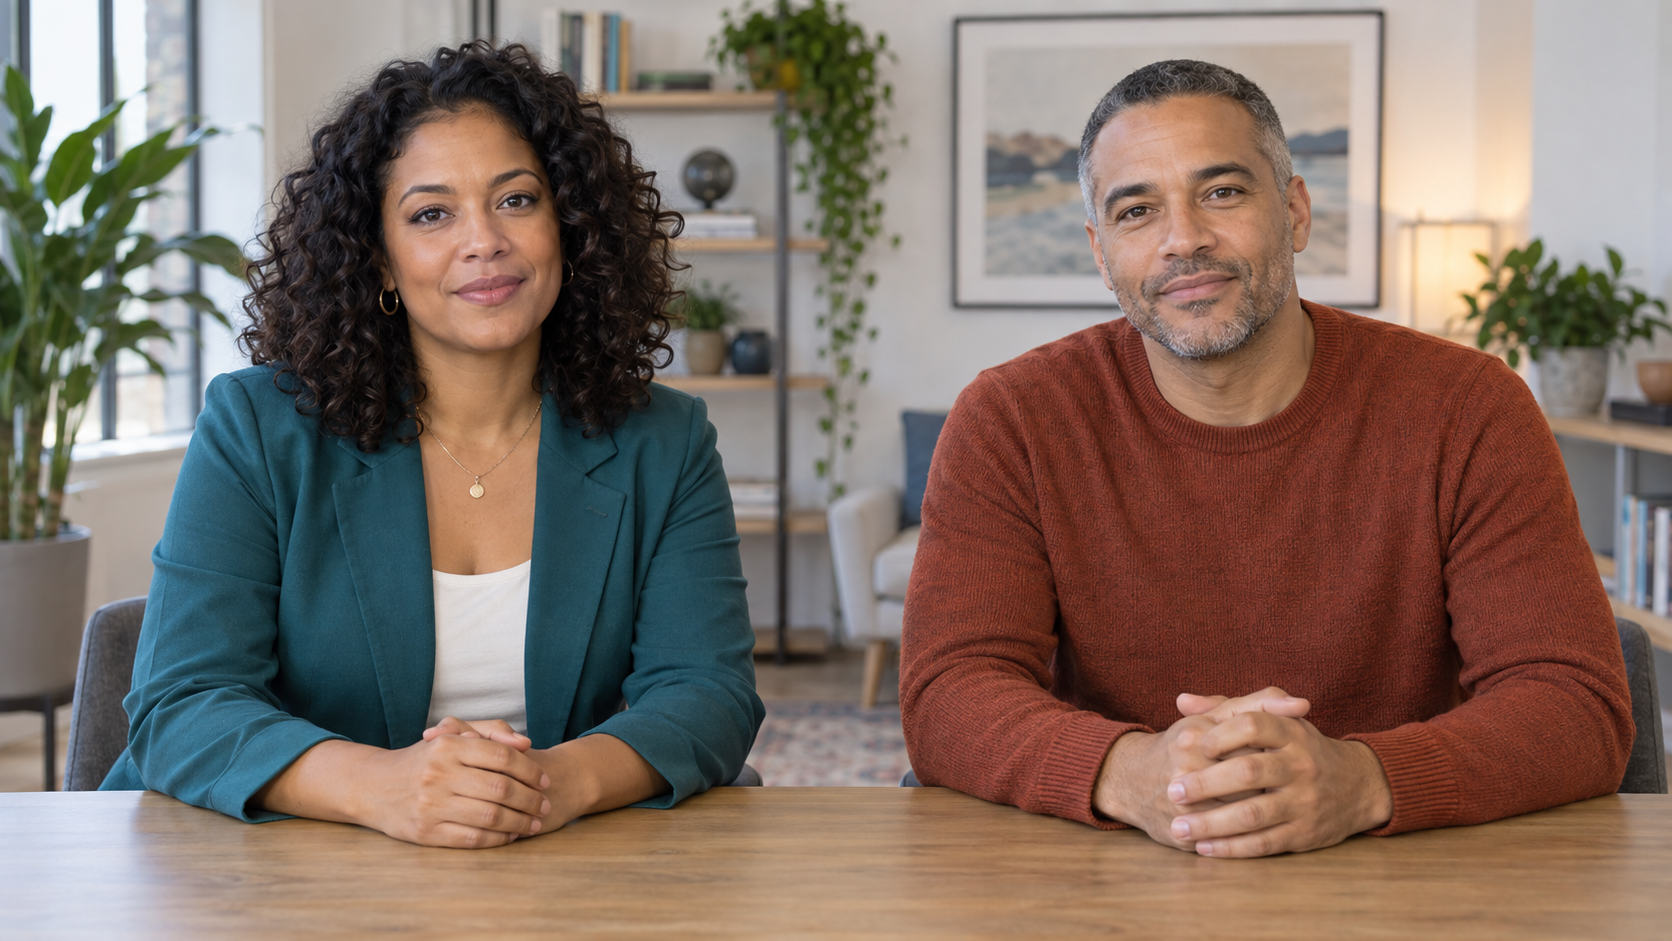
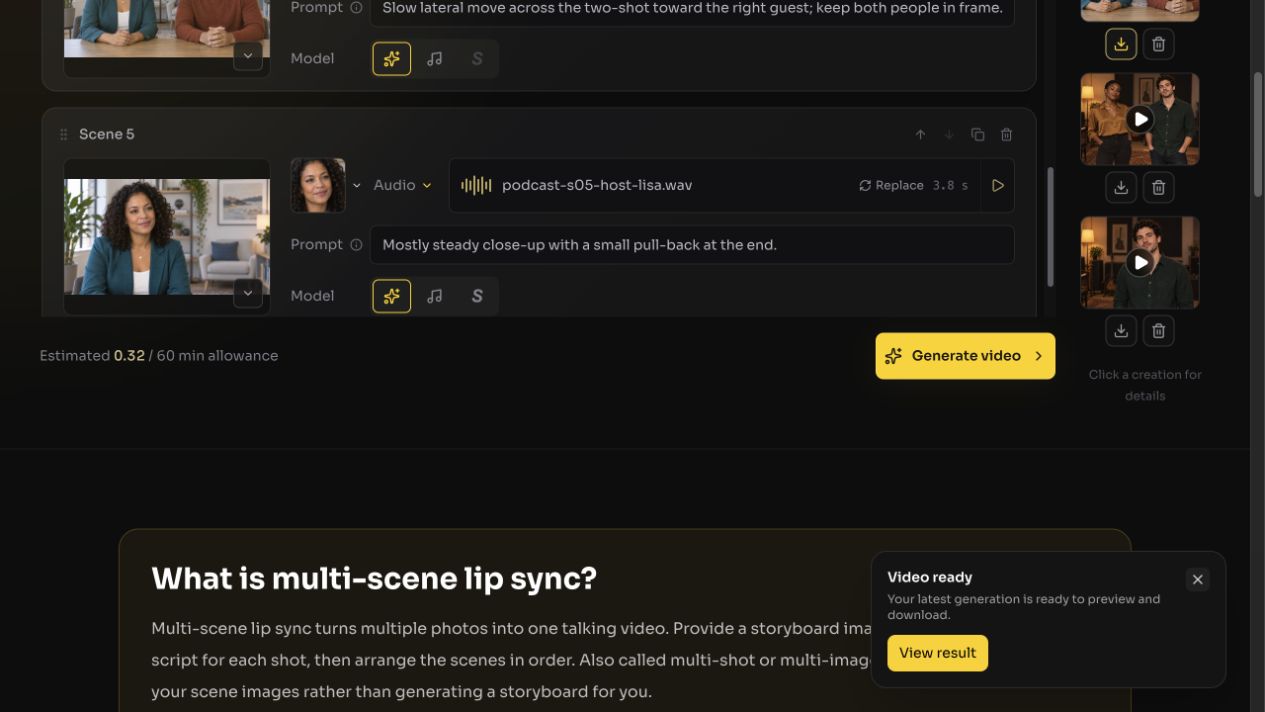
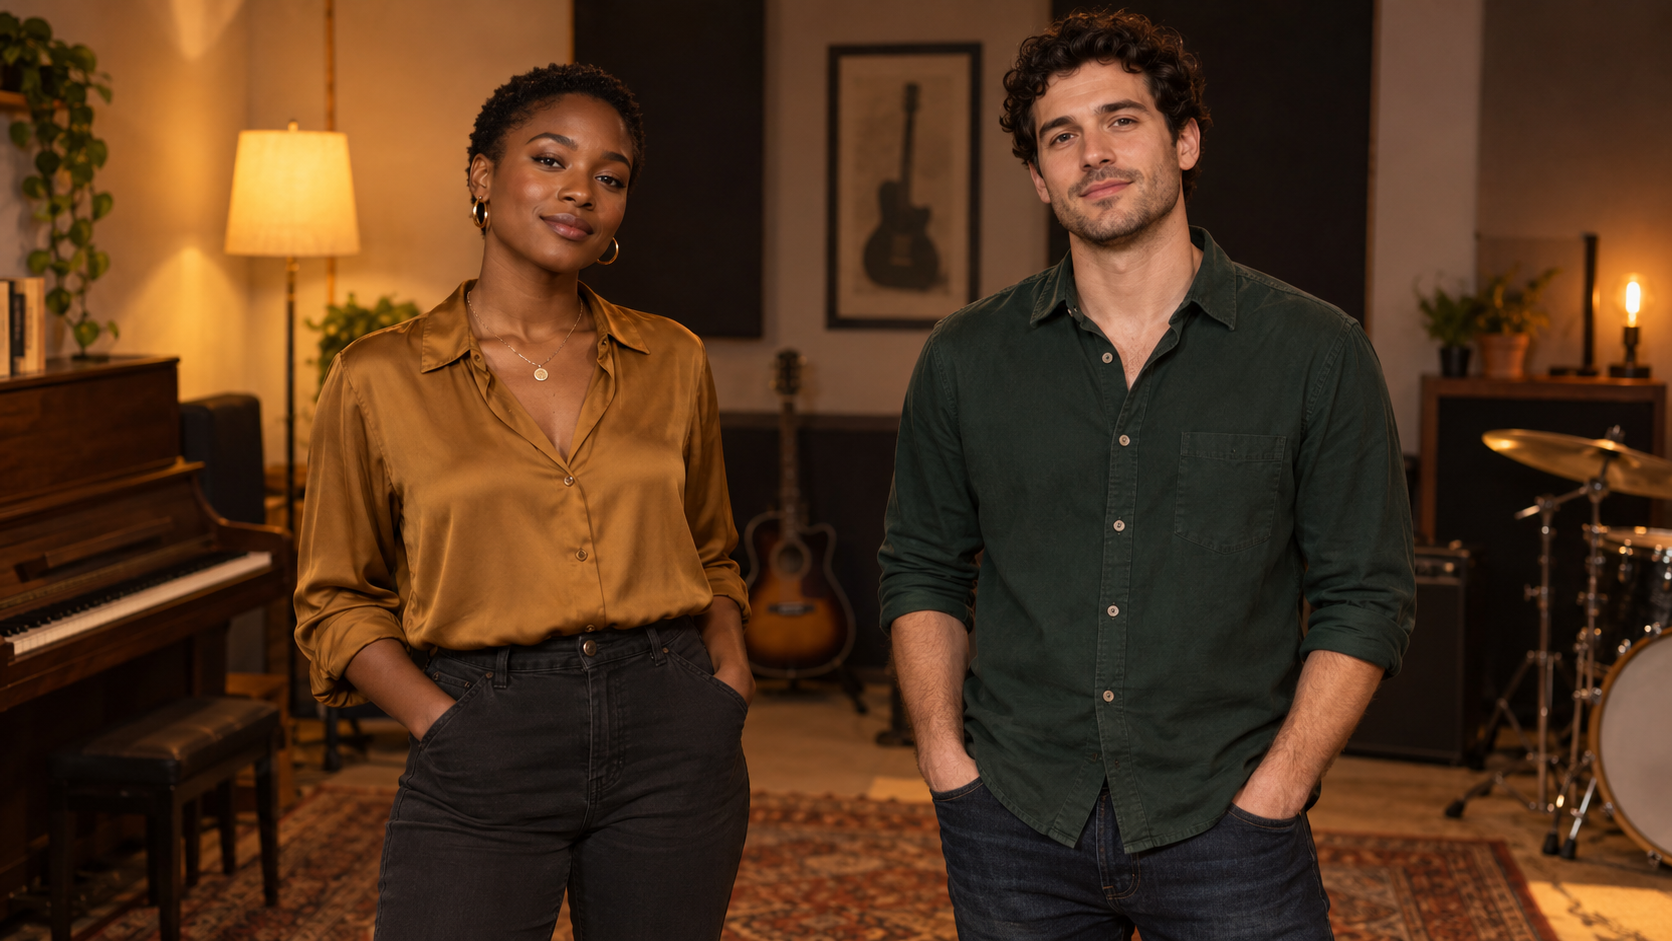
يعرض الدليل مخططين من خمس لقطات؛ بودكاست لمقدم وضيف وفيديو موسيقي لمغنيين. وتوضح لقطة المحرر ترتيب المشاهد.
ما الذي تراجعه قبل النشر؟
راقب ثبات مظهر الشخصيات وإيقاع القطع بين المشاهد. اختر الوضع الملائم للقطة فردية أو ثنائية؛ لا يضمن الوصف توقيت كل انتقال بدقة.
الأسئلة الشائعة
هل تنشئ الأداة جميع اللقطات تلقائيًا؟
لا. جهّز صورة وصوتًا لكل مشهد ورتبها على الخط الزمني، ثم أضف تعليمات الحركة عند الحاجة.


